Startseite > Infrastruktur > Scheduling auf GPU-Clustern
Scheduling: Wie Rechenzeit auf GPU-Clustern verteilt wird
Ein GPU-Cluster kostet viel Geld, auch wenn er nichts tut. Welche Aufgabe wann auf welchen Rechnern läuft, entscheidet ein Scheduler. Seine Regeln bestimmen, ob teure Hardware ausgelastet ist und wie lange Forschende auf Ergebnisse warten.
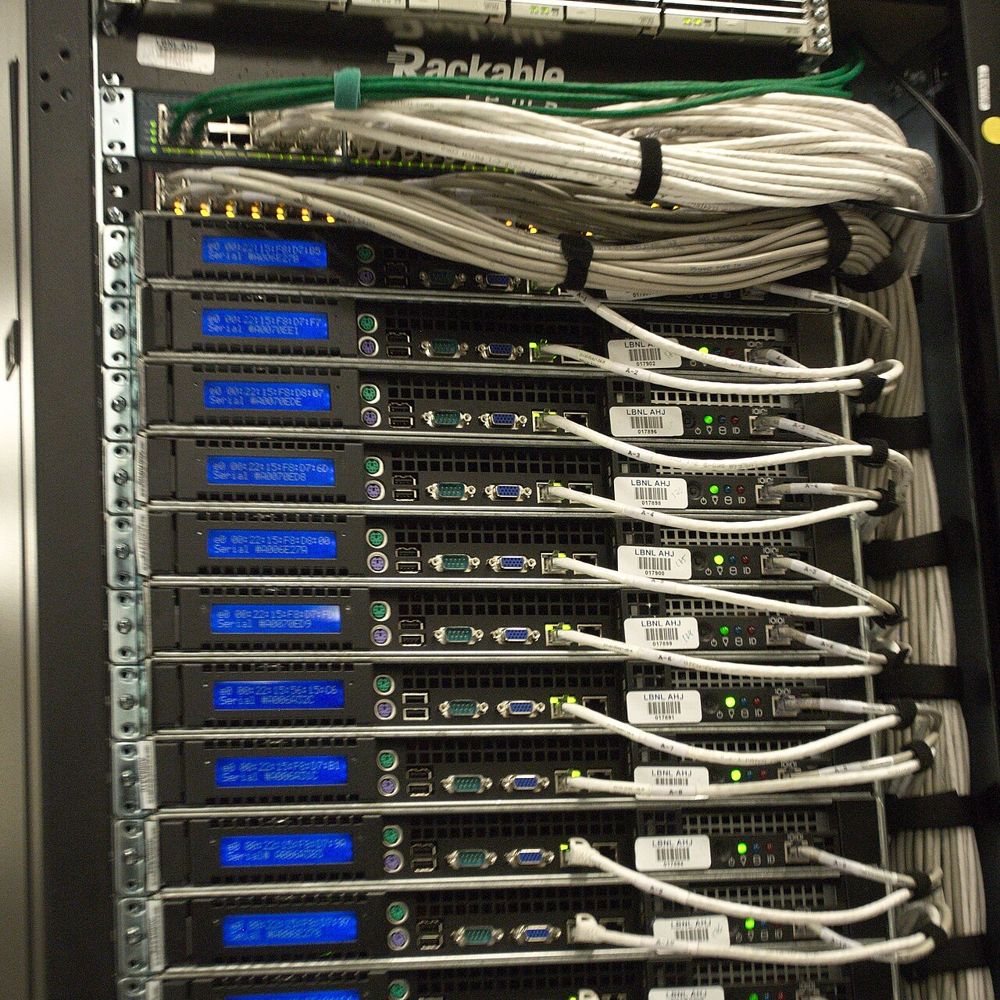
Was ein Scheduler tut
In einem gemeinsam genutzten Cluster reichen viele Nutzer Aufträge (Jobs) ein: ein Training auf 512 GPUs für drei Tage, eine Auswertung auf 8 GPUs für zwei Stunden, ein Test auf einer einzelnen Karte. Der Scheduler verwaltet Warteschlangen, prüft, welche Ressourcen frei sind, und startet Jobs, sobald ihre Anforderungen erfüllt werden können. Im wissenschaftlichen Hochleistungsrechnen ist dafür die freie Software Slurm verbreitet; in Cloud-Umgebungen übernimmt häufig Kubernetes mit Erweiterungen für Batch-Aufträge diese Rolle.
Alles oder nichts
Verteiltes Training hat eine Eigenheit: Ein Job mit 512 GPUs kann erst starten, wenn alle 512 gleichzeitig verfügbar sind. Laufen nur 500 an, rechnen sie nicht schneller, sondern warten auf die fehlenden. Scheduler müssen deshalb Gruppen von Ressourcen gemeinsam zuteilen (Gang Scheduling). Das erzeugt ein bekanntes Problem: Während der Scheduler GPUs für einen großen Job sammelt, stehen diese leer.
Die gängige Antwort heißt Backfilling. Kleine Jobs dürfen in die Lücken rutschen, solange sie den geplanten Startzeitpunkt des großen Jobs nicht verzögern. Dafür muss jeder Job eine maximale Laufzeit angeben. Wer zu großzügig schätzt, wird seltener eingeschoben; wer zu knapp schätzt, wird abgebrochen.
| Job | GPUs | Laufzeit | Ergebnis |
|---|---|---|---|
| A, läuft | 8 | noch 4 Stunden | belegt die Hälfte |
| B, wartet | 16 | 2 Tage | startet in 4 Stunden |
| C, wartet | 8 | 3 Stunden | darf sofort in die freie Hälfte |
| D, wartet | 8 | 6 Stunden | muss warten, würde B verzögern |
Fairness und Prioritäten
Wenn mehrere Gruppen sich einen Cluster teilen, soll keine dauerhaft alles belegen. Fair-Share-Verfahren senken die Priorität derer, die in letzter Zeit viel gerechnet haben. Zusätzlich gibt es Kontingente pro Projekt, getrennte Partitionen für kurze Tests und lange Läufe und die Möglichkeit, niedrig priorisierte Jobs zu verdrängen (Preemption), wenn ein dringender Auftrag kommt. Verdrängung ist nur sinnvoll, wenn der unterbrochene Job von einem Checkpoint aus weiterlaufen kann.
Die Topologie zählt
Nicht jede Zuteilung ist gleich gut. Acht GPUs im selben Server kommunizieren um ein Vielfaches schneller als acht GPUs auf acht verschiedenen Servern. Große Cluster sind zudem hierarchisch verkabelt: Rechner am selben Netzwerkswitch tauschen Daten schneller aus als Rechner an entfernten Enden. Ein guter Scheduler kennt diese Topologie und vergibt zusammenhängende Blöcke. Das führt zu Fragmentierung, wenn kleine Jobs die Blöcke zerstückeln, ein Zielkonflikt, an dem viel geforscht wird.
Zufall als Werkzeug
Ein Ergebnis aus der theoretischen Informatik spielt bei der Verteilung vieler kleiner Aufgaben eine Rolle, etwa bei Inferenz-Anfragen an Hunderte Server. Verteilt man Aufgaben rein zufällig, werden einige Server deutlich überlastet. Wählt man dagegen für jede Aufgabe zwei Server zufällig aus und nimmt den weniger belasteten, sinkt die maximale Last drastisch. Dieses Prinzip ("Power of Two Choices", unter anderem von Michael Mitzenmacher untersucht) ist einfach, braucht kaum Koordination und findet sich in vielen Lastverteilern.
Inferenz stellt andere Fragen
Beim Beantworten von Chatbot-Anfragen geht es nicht um Warteschlangen über Tage, sondern um Millisekunden. Hier verteilt ein Router Anfragen auf Modellinstanzen, berücksichtigt, wo bereits passende Zwischenspeicher liegen, und fährt Instanzen je nach Tageszeit hoch oder herunter. Trainings- und Inferenzlast teilen sich zunehmend dieselben Cluster: tagsüber mehr Anfragen, nachts mehr Training. Dazu passt der Beitrag über Inferenz.
Warum das Thema unterschätzt wird
Bei Investitionen in Milliardenhöhe entscheidet die Auslastung über die Wirtschaftlichkeit. Ein Cluster, der zu 60 statt zu 90 Prozent genutzt wird, verschwendet ein Drittel seiner Kapazität, einschließlich des Stroms für Leerlauf und Kühlung. Scheduling ist damit auch eine Energiefrage.
Was Nutzer selbst beitragen
Ein Scheduler kann nur so gut planen, wie die Angaben der Nutzer es erlauben. In Rechenzentren, die GPU-Zeit an viele Gruppen verteilen, gelten deshalb einige Regeln guter Praxis:
- Laufzeiten realistisch angeben, mit etwas Puffer, aber nicht pauschal das Maximum.
- Nur so viele GPUs anfordern, wie das Programm tatsächlich auslastet. Ein Job, der acht Karten reserviert und zwei nutzt, blockiert sechs.
- Regelmäßig Checkpoints schreiben, damit Abbrüche und Verdrängung wenig kosten.
- Vor einem großen Lauf einen kurzen Test mit wenigen Knoten machen, um Konfigurationsfehler früh zu finden.
- Auslastung beobachten: Viele Cluster zeigen pro Job an, wie stark Rechenwerke und Speicher genutzt werden.
Manche Zentren werten diese Daten aus und sprechen Gruppen mit dauerhaft schlechter Auslastung gezielt an. Das ist weniger Kontrolle als Hilfe, denn oft liegt die Ursache in einer ungünstigen Einstellung, die sich mit wenig Aufwand beheben lässt.
Stand: November 2026, Redaktion fast project